Сгенерированный текст узнаётся с первого абзаца: симметричные конструкции, перечисления по три, вводные фразы вроде «в современном быстро меняющемся мире» и заключения, которые ничего не заключают. Проблема не в том, что AI пишет плохо, — проблема в том, что он пишет одинаково. Для редакций и контент-команд, которые производят десятки материалов в неделю, эта одинаковость становится системным риском: читатели и алгоритмы учатся распознавать паттерны, бренд-голос размывается, а материалы теряют цитируемость в AI-ответчиках, которые предпочитают уникальные формулировки.
Хорошая новость: большая часть роботизированности AI-текста устранима системной редактурой. Не разовой правкой «сделай красивее», а последовательным применением техник, которые можно превратить в повторяемый воркфлоу. В этом практикуме — конкретные приёмы для текста и видео-сценариев, порядок применения и способы проверки результата.
Почему AI-текст звучит неестественно: структурные причины
Роботизированность AI-текета — не случайность, а следствие архитектуры языковых моделей. LLM предсказывают следующий токен на основе вероятностного распределения, и это распределение тяготеет к наиболее частотным конструкциям. Результат — текст, который статистически «правильный», но лишённый индивидуальности.
Ключевые маркеры неестественности:
- Симметрия перечислений. AI обожает группы по три пункта одинаковой длины. Реальные авторы так не пишут — они дают два коротких и один развёрнутый, или один пункт с примером, а два без.
- Равномерный ритм предложений. Все предложения примерно одной длины — 15–20 слов. Живой текст чередует короткие и длинные.
- Избыточные вводные конструкции. «Важно отметить», «следует подчеркнуть», «необходимо учитывать» — filler-фразы, которые не несут смысла.
- Параллелизм структуры. Каждый абзац построен по одной схеме: тезис → объяснение → пример. Это делает текст предсказуемым.
- Отсутствие авторской позиции. AI стремится к нейтральности, поэтому текст звучит как Википедия, а не как экспертный материал.
Три стадии натурализации: тон, ритм, контекст
Редактура AI-текста работает как пайплайн. Если применять приёмы хаотично, результат будет хуже, чем от последовательного прохождения трёх стадий.
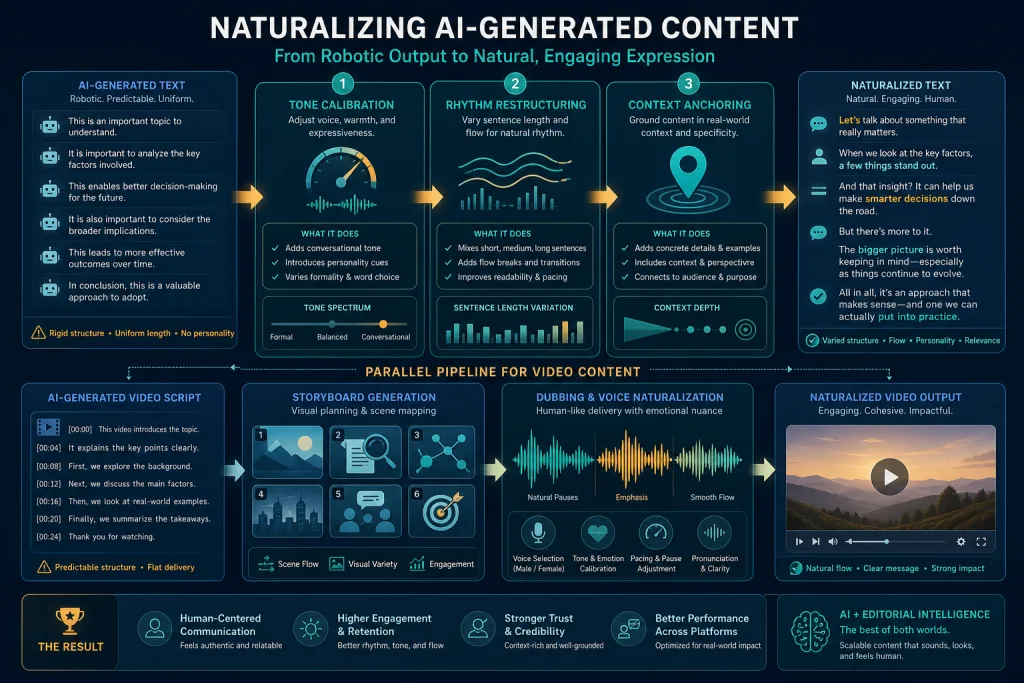
Стадия 1: Калибровка тона
Тон — это не «сделай дружелюбнее». Тон — это соответствие голосу бренда и контексту материала. Для редакций это означает, что до начала правки должен быть зафиксирован эталонный голос: примеры 3–5 материалов, которые команда считает образцовыми.
Практический приём — tone-matching через few-shot промпт. Вместо того чтобы просить AI «перепиши естественнее», загрузите 2–3 абзаца эталонного текста и попросите модель проанализировать их стиль: длина предложений, использование местоимений, уровень формальности, типы аргументации. Затем попросите применить этот профиль к сгенерированному тексту.
Для видео-сценариев калибровка тона критичнее, чем для статей. Сценарий, который звучит роботизированно в голосовом озвучивании, убивает удержание в первые 10 секунд. Проверьте сценарий, прочитав его вслух: если вы спотыкаетесь или автоматически меняете слова при чтении — текст неестественный.
Стадия 2: Реструктуризация ритма
Ритм — это вариативность длины предложений и абзацев. AI-текст обычно имеет плоский ритм: все предложения средней длины, все абзацы по 3–4 предложения. Живой текст дышит.
Техника редактуры:
- Найдите самое длинное предложение в абзаце и разбейте его на два.
- Найдите самый короткий абзац и объедините с соседним — или, наоборот, выделите одно предложение в отдельный абзац для акцента.
- Удалите 30–40% вводных слов. Оставьте только те, которые реально создают логический переход.
- Проверьте, есть ли в тексте хотя бы одно предложение короче 8 слов. Если нет — текст слишком равномерный.
Для видео-сценариев ритм измеряется иначе: в секундах произнесения. Идеальный ритм для YouTube — чередование 5–10-секундных фраз с одной 15–20-секундной. Для шортсов — фразы по 3–7 секунд. AI-сценарии часто генерируют фразы одинаковой длительности, что в озвучивании звучит монотонно.
Стадия 3: Контекстное анкорирование
Это самая важная и самая трудная стадия. AI-текст существует в вакууме — он не привязан к вашему опыту, вашим данным, вашей аудитории. Контекстное анкорирование — это внедрение в текст конкретики, которая делает его вашим.
Приёмы анкорирования:
- Первичные данные. Вставьте результаты собственного исследования, цифры из вашей аналитики, цитаты реальных клиентов. AI не может это сгенерировать — это ваш единственный источник.
- Отсылки к предыдущим материалам. «Как мы писали в разборе про MCP-коннекторы…» — это создаёт ткань, которую AI не производит.
- Локальные примеры. Вместо «компании используют AI» — «редакция из 12 человек, которая производит 40 материалов в неделю, использует AI для…».
- Ограничения и нюансы. AI стремится к универсальности. Реальный эксперт всегда добавляет «но это работает только при условии…» или «в нашем случае это не сработало, потому что…».
Воркфлоу редактуры: от черновика до публикации
Системная редактура AI-текета требует процесса, а не вдохновения. Вот воркфлоу, который можно внедрить в редакции любого размера.
Шаг 1: Генерация с заданными ограничениями. Не просите AI «написать статью». Задайте ограничения: «напиши раздел из 200 слов, используй предложения разной длины (от 5 до 30 слов), не используй вводные конструкции ‘важно отметить’ и ‘следует учитывать’, начни с конкретного примера, а не с обобщения». Ограничения на этапе генерации сокращают время редактуры на 40–50%.
Шаг 2: Прохождение трёх стадий. Тон → ритм → контекст. Каждую стадию можно частично автоматизировать промптом, но финальная проверка — человеческая. На стадии тона используйте few-shot промпт с эталонами. На стадии ритма — попросите AI проанализировать распределение длин предложений и предложить точки разрыва. На стадии контекста — ручная работа, AI здесь не помощник.
Шаг 3: Мультимодальная проверка. Для видео-сценариев — обязательная проверка через TTS-озвучку. Прогоните сценарий через любой качественный text-to-speech движок и послушайте. Проблемы ритма и тона, незаметные на бумаге, становятся очевидными в аудио. Для текста — проверьте через чтение вслух первые 200 слов.
Шаг 4: Проверка на паттерны. Прогоните текст через детектор AI-паттернов (не детектор AI-контента — это разные вещи). Паттерн-детектор ищет не «написал ли AI», а «звучит ли как AI»: симметричные перечисления, равномерный ритм, filler-фразы. Если паттерны остались — вернитесь к стадии 2.
Специфика для видео-сценариев
Видео-сценарии — это отдельный класс AI-контента с своими проблемами. Статья может быть «роботизированной», но читатель всё равно дочитает. Сценарий, который звучит неестественно, теряет зрителя за 15 секунд.
Типичные проблемы AI-сценариев:
- Слишком плотная информация. AI пытается впихнуть максимум фактов в минимум времени. Реальные успешные сценарии оставляют паузы, вопросы, моменты для消化.
- Отсутствие разговорных маркеров. Живая речь содержит «ну», «вот», «на самом деле», незаконченные мысли, самоперебивания. AI-сценарии этого не делают.
- Универсальный hook. «В этом видео мы расскажем о…» — это не hook, это анонс. Hook должен быть конкретным: «За последние 30 дней мы сгенерировали 200 видео и вот что узнали».
- Закадровый vs лицевой текст. AI не различает, что будет говориться за кадром, а что — в кадре. Для закадрового текста допустимы более сложные конструкции, для лицевого — нужен разговорный регистр.
Практический приём для видео-команд: генерируйте сценарий в два прохода. Первый проход — структура и факты. Второй проход — промпт «перепиши этот сценарий для устной речи: сократи предложения до 12 слов, добавь разговорные маркеры, замени сложные термины на простые аналогии, добавь 2–3 риторических вопроса».
Мультимодальная проверка: текст + аудио + видео
Современные AI-инструменты позволяют проверять естественность контента не только на уровне текста, но и на уровне аудио и видео. Это особенно важно для команд, которые производят контент в нескольких форматах.
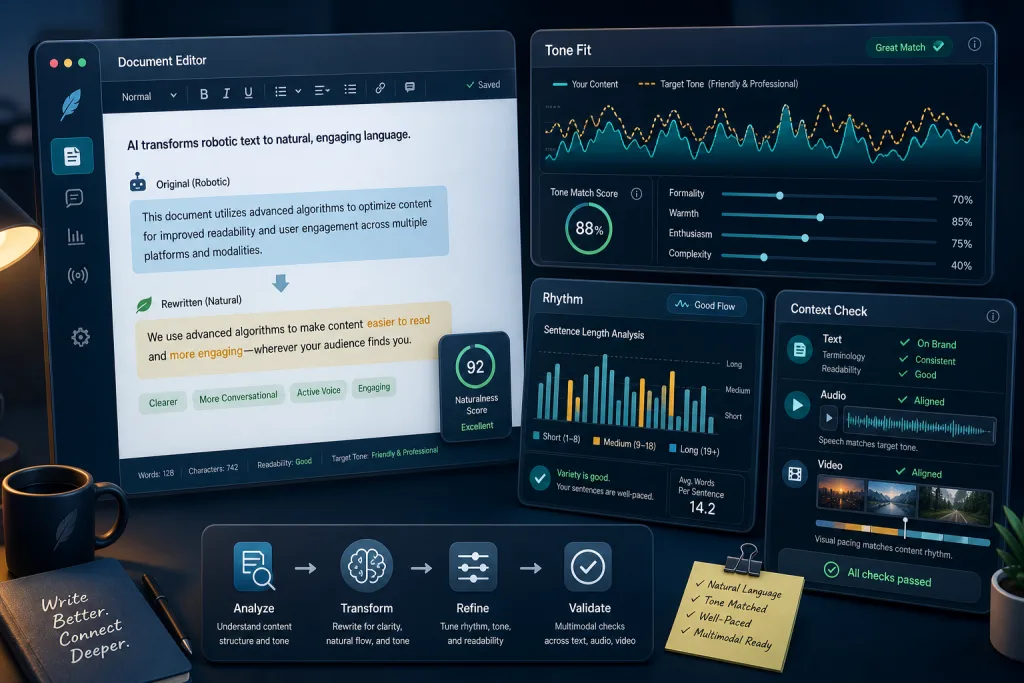
Для текста: помимо чтения вслух, используйте AI-анализ читаемости. Промпт: «проанализируй этот текст на уровень естественности по шкале от 1 до 10. Оцени: вариативность длины предложений, наличие filler-фраз, симметрию перечислений, наличие авторской позиции. Дай конкретные рекомендации по каждому пункту».
Для аудио: TTS-озвучка с последующим прослушиванием. Обратите внимание на места, где голос «спотыкается» — обычно это длинные предложения или стыки абзацев.
Для видео: если сценарий будет озвучиваться AI-дубляжом, проверьте, как текст ложится на тайминг. AI-генераторы видео часто создают сцены по 3–5 секунд, и сценарий должен адаптироваться под этот ритм, а не наоборот.
Интеграция в контент-операции
Натурализация AI-текста — не разовая задача, а системный процесс. Чтобы он работал в масштабе, нужны три элемента.
Эталонная библиотека. Набор из 10–20 текстовых фрагментов, которые команда считает образцовыми по стилю. Эти фрагменты используются как few-shot примеры в промптах и как эталон для редакторской проверки.
Чеклист редактуры. Стандартизированный список проверок, который редактор проходит для каждого материала. Не «сделай хорошо», а «проверь наличие коротких предложений, удали filler-фразы, добавь первичные данные, проверь ритм через чтение вслух».
Метрика естественности. Простой скоринг: редактор оценивает материал от 1 до 5 по критерию «звучит ли как написанный человеком». Если оценка ниже 4 — материал возвращается на доработку. Со временем команда калибруется, и средний балл растёт.
Чеклист: проверка естественности AI-текста
- В тексте есть хотя бы одно предложение короче 8 слов и хотя бы одно длиннее 25 слов
- Удалены все вводные filler-фразы: «важно отметить», «следует учитывать», «необходимо подчеркнуть»
- Перечисления не симметричны: пункты разной длины и с разной степенью детализации
- В тексте есть первичные данные, отсылки к предыдущим материалам или локальные примеры
- Первые 200 слов прочитаны вслух без спотыканий
- Для видео-сценариев: TTS-озвучка прослушана, ритм фраз неравномерный
- Текст прошёл проверку на AI-паттерны: нет равномерного ритма и универсальных обобщений
Ошибки, которые делают редакции
Первая и самая частая ошибка — попытка исправить всё одним промптом. «Перепиши этот текст, чтобы он звучал естественно» — это не работает. AI не знает, что вы считаете естественным. Естественность — это не свойство текста, это соответствие контексту: голосу бренда, ожиданиям аудитории, формату публикации.
Вторая ошибка — чрезмерная правка. Когда редактор видит AI-текст, он часто переписывает 80% материала. Если вам нужно переписать 80% — проще написать с нуля. Цель редактуры — сохранить 60–70% сгенерированного текста и трансформировать 30–40%, которые звучат неестественно.
Третья ошибка — игнорирование видео-сценариев. Команды, которые активно используют AI для текста, часто относятся к сценариям как к «тексту, который потом озвучат». Но сценарий — это не текст. Это устная речь, записанная на бумаге, и правила естественности для неё другие.
Измеримые результаты
Как понять, что редактура работает? Три метрики, которые стоит отслеживать.
Время на редактуру. При внедрении системного воркфлоу время правки одного материала должно сократиться с 5–6 часов (типичный показатель для AI-редакторов) до 2–3 часов. Если время не сокращается — воркфлоу не работает.
Удержание для видео. Для видео-сценариев, прошедших натурализацию, retention в первые 30 секунд должен вырасти на 10–15% по сравнению с «сырыми» AI-сценариями. Это измеряется в YouTube Analytics или аналитике платформы.
Цитируемость в AI-ответчиках. Естественный, оригинальный текст с первичными данными цитируется в ChatGPT, Perplexity и Gemini чаще, чем шаблонный AI-контент. Отслеживайте упоминания бренда в AI-ответах по ключевым запросам.
FAQ
Можно ли полностью автоматизировать редактуру AI-текста?
Нет. Стадии калибровки тона и реструктуризации ритма можно частично автоматизировать промптами, но контекстное анкорирование — внедрение первичных данных, отсылок и авторской позиции — требует человеческого редактора. Цель автоматизации — сократить рутину, а не заменить редакторское суждение.
Какие промпты работают лучше всего для натурализации?
Few-shot промпты с эталонными примерами работают лучше, чем инструкции вроде «пиши естественнее». Загрузите 2–3 фрагмента вашего лучшего текста, попросите AI проанализировать стиль, затем примените найденный профиль к сгенерированному тексту. Конкретные ограничения (длина предложений, запрет filler-фраз) работают лучше абстрактных просьб.
Чем редактура видео-сценариев отличается от редактуры статей?
Сценарий — это устная речь, а не письменный текст. Критерии другие: фразы до 12 слов для лицевого текста, разговорные маркеры, риторические вопросы, паузы. Обязательная проверка — TTS-озвучка и прослушивание. Для шортсов фразы должны быть ещё короче — 3–7 секунд произнесения.
Как измерить, что текст стал «естественнее»?
Три способа: чтение вслух первых 200 слов (если не спотыкаетесь — хорошо), скоринг редактором от 1 до 5, и проверка через AI-анализ паттернов (симметрия, ритм, filler-фразы). Для видео — retention в первые 30 секунд после внедрения натурализованных сценариев.
Стоит ли использовать детекторы AI-контента для проверки?
Детекторы AI-контента и детекторы AI-паттернов — разные инструменты. Детекторы контента ищут «написал ли AI» и часто ошибаются. Детекторы паттернов ищут конкретные маркеры роботизированности: равномерный ритм, симметричные перечисления, filler-фразы. Вторые полезнее для редактуры, потому что дают конкретные точки исправления.
Итог
Естественность AI-текста — это не магия и не талант. Это системный процесс из трёх стадий: калибровка тона по эталонам, реструктуризация ритма через вариативность длины предложений и контекстное анкорирование через первичные данные и авторскую позицию. Для видео-сценариев добавляется обязательная проверка через TTS-озвучку. Внедрённый как повторяемый воркфлоу с эталонной библиотекой, чеклистом и метрикой естественности, этот процесс сокращает время редактуры в 2 раза и повышает удержание и цитируемость контента. Главная ошибка — пытаться исправить всё одним промптом. Главная победа — превратить редактуру в операционную систему, а не в индивидуальное мастерство.