Згенерований текст впізнається з першого абзацу: симетричні конструкції, переліки по три, вступні фрази на кшталт «у сучасному швидкоплинному світі» та висновки, які нічого не підсумовують. Проблема не в тому, що AI пише погано, — проблема в тому, що він пише однаково. Для редакцій та контент-команд, які створюють десятки матеріалів на тиждень, ця однаковість стає системним ризиком: читачі та алгоритми вчаться розпізнавати патерни, бренд-войс розмивається, а матеріали втрачають цитованість у AI-відповідачах, які віддають перевагу унікальним формулюванням.
Гарна новина: більшу частину роботизованості AI-тексту можна усунути системною редактурою. Не одноразовою правкою «зроби гарніше», а послідовним застосуванням технік, які можна перетворити на повторюваний воркфлоу. У цьому практикумі — конкретні прийоми для тексту та відеосценаріїв, порядок застосування та способи перевірки результату.
Чому AI-текст звучить неприродно: структурні причини
Роботизованість AI-тексту — не випадковість, а наслідок архітектури мовних моделей. LLM передбачають наступний токен на основі ймовірнісного розподілу, і цей розподіл тяжіє до найчастотніших конструкцій. Результат — текст, який статистично «правильний», але позбавлений індивідуальності.
Ключові маркери неприродності:
- Симетрія переліків. AI обожнює групи по три пункти однакової довжини. Реальні автори так не пишуть — вони дають два короткі та один розгорнутий, або один пункт з прикладом, а два без.
- Рівномірний ритм речень. Усі речення приблизно однакової довжини — 15–20 слів. Живий текст чергує короткі та довгі.
- Зайві вступні конструкції. «Важливо відзначити», «слід підкреслити», «необхідно враховувати» — filler-фрази, які не несуть змісту.
- Паралелізм структури. Кожен абзац побудований за однією схемою: теза → пояснення → приклад. Це робить текст передбачуваним.
- Відсутність авторської позиції. AI прагне до нейтральності, тому текст звучить як Вікіпедія, а не як експертний матеріал.
Три стадії натуралізації: тон, ритм, контекст
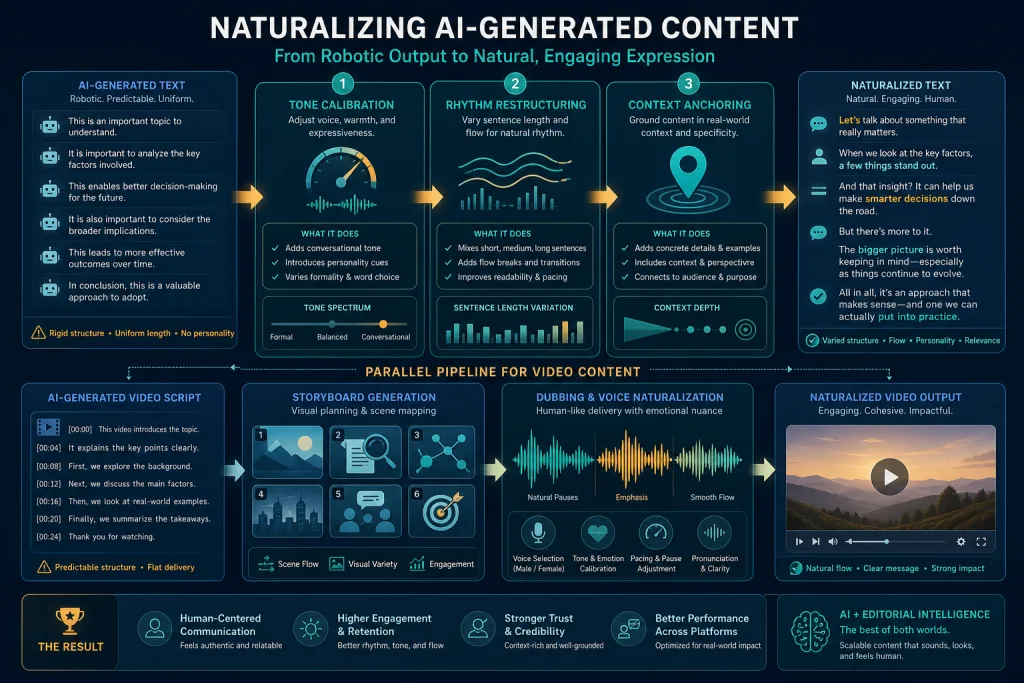
Редактура AI-тексту працює як пайплайн. Якщо застосовувати прийоми хаотично, результат буде гіршим, ніж від послідовного проходження трьох стадій.
Стадія 1: Калібрування тону
Тон — це не «зроби дружелюбніше». Тон — це відповідність голосу бренду та контексту матеріалу. Для редакцій це означає, що до початку правки має бути зафіксований еталонний голос: приклади 3–5 матеріалів, які команда вважає зразковими.
Практичний прийом — tone-matching через few-shot промпт. Замість того, щоб просити AI «перепиши природніше», завантажте 2–3 абзаци еталонного тексту та попросіть модель проаналізувати їхній стиль: довжина речень, використання займенників, рівень формальності, типи аргументації. Потім попросіть застосувати цей профіль до згенерованого тексту.
Для відеосценаріїв калібрування тону критичніше, ніж для статей. Сценарій, який звучить роботизовано у голосовому озвученні, вбиває утримання в перші 10 секунд. Перевірте сценарій, прочитавши його вголос: якщо ви спотикаєтесь або автоматично змінюєте слова при читанні — текст неприродний.
Стадія 2: Реструктуризація ритму
Ритм — це варіативність довжини речень та абзаців. AI-текст зазвичай має плоский ритм: усі речення середньої довжини, усі абзаци по 3–4 речення. Живий текст дихає.
Техніка редактури:
- Знайдіть найдовше речення в абзаці та розбийте його на два.
- Знайдіть найкоротший абзац та об’єднайте з сусіднім — або, навпаки, виділіть одне речення в окремий абзац для акценту.
- Видаліть 30–40% вступних слів. Залиште лише ті, які реально створюють логічний перехід.
- Перевірте, чи є в тексті хоча б одне речення коротше за 8 слів. Якщо ні — текст занадто рівномірний.
Для відеосценаріїв ритм вимірюється інакше: у секундах промовляння. Ідеальний ритм для YouTube — чергування 5–10-секундних фраз з однією 15–20-секундною. Для шортсів — фрази по 3–7 секунд. AI-сценарії часто генерують фрази однакової тривалості, що в озвученні звучить монотонно.
Стадія 3: Контекстне анкорування
Це найважливіша і найскладніша стадія. AI-текст існує у вакуумі — він не прив’язаний до вашого досвіду, ваших даних, вашої аудиторії. Контекстне анкорування — це впровадження в текст конкретики, яка робить його вашим.
Прийоми анкорування:
- Первинні дані. Вставте результати власного дослідження, цифри з вашої аналітики, цитати реальних клієнтів. AI не може це згенерувати — це ваше єдине джерело.
- Відсилання до попередніх матеріалів. «Як ми писали у розборі про MCP-конектори…» — це створює тканину, яку AI не виробляє.
- Локальні приклади. Замість «компанії використовують AI» — «редакція з 12 осіб, яка створює 40 матеріалів на тиждень, використовує AI для…».
- Обмеження та нюанси. AI прагне до універсальності. Реальний експерт завжди додає «але це працює лише за умови…» або «у нашому випадку це не спрацювало, тому що…».
Воркфлоу редактури: від чернетки до публікації
Системна редактура AI-тексту вимагає процесу, а не натхнення. Ось воркфлоу, який можна впровадити в редакції будь-якого розміру.
Крок 1: Генерація з заданими обмеженнями. Не просіть AI «написати статтю». Задайте обмеження: «напиши розділ з 200 слів, використовуй речення різної довжини (від 5 до 30 слів), не використовуй вступні конструкції ‘важливо відзначити’ і ‘слід враховувати’, почни з конкретного прикладу, а не з узагальнення». Обмеження на етапі генерації скорочують час редактури на 40–50%.
Крок 2: Проходження трьох стадій. Тон → ритм → контекст. Кожну стадію можна частково автоматизувати промптом, але фінальна перевірка — людська. На стадії тону використовуйте few-shot промпт з еталонами. На стадії ритму — попросіть AI проаналізувати розподіл довжини речень і запропонувати точки розриву. На стадії контексту — ручна робота, AI тут не помічник.
Крок 3: Мультимодальна перевірка. Для відеосценаріїв — обов’язкова перевірка через TTS-озвучку. Пропустіть сценарій через будь-який якісний text-to-speech рушій і послухайте. Проблеми ритму та тону, непомітні на папері, стають очевидними в аудіо. Для тексту — перевірте через читання вголос перших 200 слів.
Крок 4: Перевірка на патерни. Пропустіть текст через детектор AI-патернів (не детектор AI-контенту — це різні речі). Патерн-детектор шукає не «чи написав AI», а «чи звучить як AI»: симетричні переліки, рівномірний ритм, filler-фрази. Якщо патерни залишилися — поверніться до стадії 2.
Специфіка для відеосценаріїв
Відеосценарії — це окремий клас AI-контенту зі своїми проблемами. Стаття може бути «роботизованою», але читач усе одно дочитає. Сценарій, який звучить неприродно, втрачає глядача за 15 секунд.
Типові проблеми AI-сценаріїв:
- Занадто щільна інформація. AI намагається втиснути максимум фактів у мінімум часу. Реальні успішні сценарії залишають паузи, запитання, моменти для засвоєння.
- Відсутність розмовних маркерів. Живе мовлення містить «ну», «ось», «насправді», незакінчені думки, самоперебивання. AI-сценарії цього не роблять.
- Універсальний hook. «У цьому відео ми розповімо про…» — це не hook, це анонс. Hook має бути конкретним: «За останні 30 днів ми згенерували 200 відео і ось що дізналися».
- Закадровий vs лицьовий текст. AI не розрізняє, що буде говоритися за кадром, а що — в кадрі. Для закадрового тексту допустимі складніші конструкції, для лицьового — потрібен розмовний регістр.
Практичний прийом для відеокоманд: генеруйте сценарій у два проходи. Перший прохід — структура та факти. Другий прохід — промпт «перепиши цей сценарій для усного мовлення: скороти речення до 12 слів, додай розмовні маркери, заміни складні терміни на прості аналогії, додай 2–3 риторичних запитання».
Мультимодальна перевірка: текст + аудіо + відео
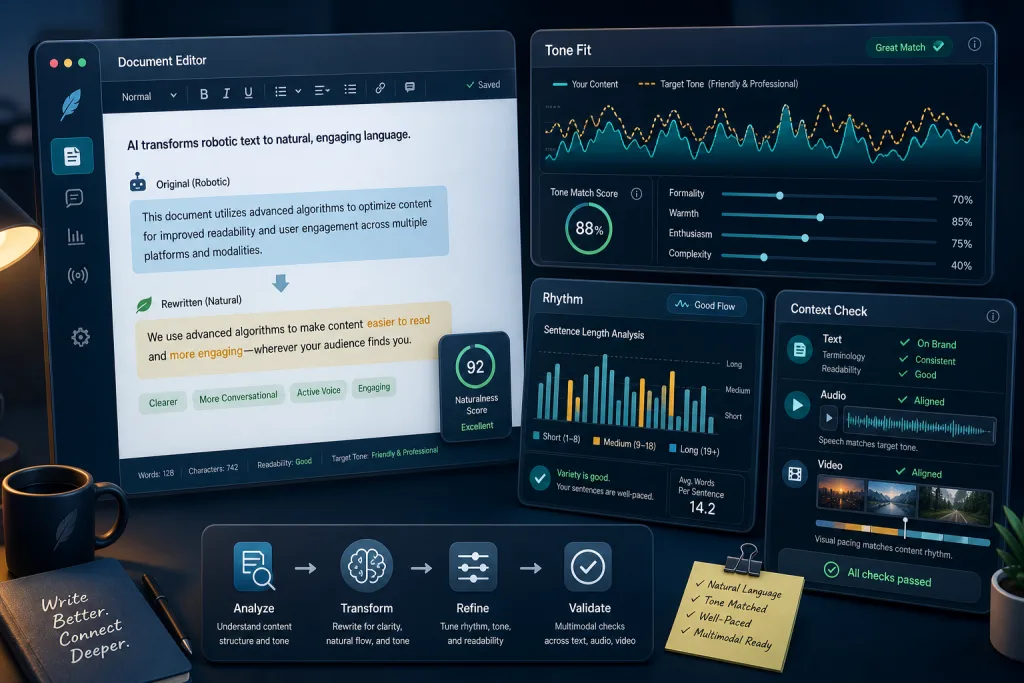
Сучасні AI-інструменти дозволяють перевіряти природність контенту не лише на рівні тексту, а й на рівні аудіо та відео. Це особливо важливо для команд, які створюють контент у кількох форматах.
Для тексту: окрім читання вголос, використовуйте AI-аналіз читабельності. Промпт: «проаналізуй цей текст на рівень природності за шкалою від 1 до 10. Оціни: варіативність довжини речень, наявність filler-фраз, симетрію переліків, наявність авторської позиції. Дай конкретні рекомендації по кожному пункту».
Для аудіо: TTS-озвучка з подальшим прослуховуванням. Зверніть увагу на місця, де голос «спотикається» — зазвичай це довгі речення або стики абзаців.
Для відео: якщо сценарій буде озвучуватися AI-дубляжем, перевірте, як текст лягає на таймінг. AI-генератори відео часто створюють сцени по 3–5 секунд, і сценарій має адаптуватися під цей ритм, а не навпаки.
Інтеграція в контент-операції
Натуралізація AI-тексту — не разове завдання, а системний процес. Щоб він працював у масштабі, потрібні три елементи.
Еталонна бібліотека. Набір з 10–20 текстових фрагментів, які команда вважає зразковими за стилем. Ці фрагменти використовуються як few-shot приклади в промптах та як еталон для редакторської перевірки.
Чекліст редактури. Стандартизований список перевірок, який редактор проходить для кожного матеріалу. Не «зроби добре», а «перевір наявність коротких речень, видали filler-фрази, додай первинні дані, перевір ритм через читання вголос».
Метрика природності. Простий скоринг: редактор оцінює матеріал від 1 до 5 за критерієм «чи звучить як написаний людиною». Якщо оцінка нижча за 4 — матеріал повертається на доопрацювання. З часом команда калібрується, і середній бал зростає.
Чекліст: перевірка природності AI-тексту
- У тексті є хоча б одне речення коротше за 8 слів і хоча б одне довше за 25 слів
- Видалено всі вступні filler-фрази: «важливо відзначити», «слід враховувати», «необхідно підкреслити»
- Переліки не симетричні: пункти різної довжини та з різним ступенем деталізації
- У тексті є первинні дані, відсилання до попередніх матеріалів або локальні приклади
- Перші 200 слів прочитані вголос без спотикань
- Для відеосценаріїв: TTS-озвучка прослухана, ритм фраз нерівномірний
- Текст пройшов перевірку на AI-патерни: немає рівномірного ритму та універсальних узагальнень
Помилки, які роблять редакції
Перша і найчастіша помилка — спроба виправити все одним промптом. «Перепиши цей текст, щоб він звучав природно» — це не працює. AI не знає, що ви вважаєте природним. Природність — це не властивість тексту, це відповідність контексту: голосу бренду, очікуванням аудиторії, формату публікації.
Друга помилка — надмірна правка. Коли редактор бачить AI-текст, він часто переписує 80% матеріалу. Якщо вам потрібно переписати 80% — простіше написати з нуля. Мета редактури — зберегти 60–70% згенерованого тексту і трансформувати 30–40%, які звучать неприродно.
Третя помилка — ігнорування відеосценаріїв. Команди, які активно використовують AI для тексту, часто ставляться до сценаріїв як до «тексту, який потім озвучать». Але сценарій — це не текст. Це усне мовлення, записане на папері, і правила природності для нього інші.
Вимірювані результати
Як зрозуміти, що редактура працює? Три метрики, які варто відстежувати.
Час на редактуру. При впровадженні системного воркфлоу час правки одного матеріалу має скоротитися з 5–6 годин (типовий показник для AI-редакторів) до 2–3 годин. Якщо час не скорочується — воркфлоу не працює.
Утримання для відео. Для відеосценаріїв, які пройшли натуралізацію, retention у перші 30 секунд має зрости на 10–15% порівняно з «сирими» AI-сценаріями. Це вимірюється в YouTube Analytics або аналітиці платформи.
Цитованість у AI-відповідачах. Природний, оригінальний текст з первинними даними цитується в ChatGPT, Perplexity та Gemini частіше, ніж шаблонний AI-контент. Відстежуйте згадки бренду в AI-відповідях за ключовими запитами.
FAQ
Чи можна повністю автоматизувати редактуру AI-тексту?
Ні. Стадії калібрування тону та реструктуризації ритму можна частково автоматизувати промптами, але контекстне анкорування — впровадження первинних даних, відсилань та авторської позиції — вимагає людського редактора. Мета автоматизації — скоротити рутину, а не замінити редакторське судження.
Які промпти працюють найкраще для натуралізації?
Few-shot промпти з еталонними прикладами працюють краще, ніж інструкції на кшталт «пиши природніше». Завантажте 2–3 фрагменти вашого найкращого тексту, попросіть AI проаналізувати стиль, потім застосуйте знайдений профіль до згенерованого тексту. Конкретні обмеження (довжина речень, заборона filler-фраз) працюють краще за абстрактні прохання.
Чим редактура відеосценаріїв відрізняється від редактури статей?
Сценарій — це усне мовлення, а не письмовий текст. Критерії інші: фрази до 12 слів для лицьового тексту, розмовні маркери, риторичні запитання, паузи. Обов’язкова перевірка — TTS-озвучка та прослуховування. Для шортсів фрази мають бути ще коротшими — 3–7 секунд промовляння.
Як виміряти, що текст став «природнішим»?
Три способи: читання вголос перших 200 слів (якщо не спотикаєтесь — добре), скоринг редактором від 1 до 5, та перевірка через AI-аналіз патернів (симетрія, ритм, filler-фрази). Для відео — retention у перші 30 секунд після впровадження натуралізованих сценаріїв.
Чи варто використовувати детектори AI-контенту для перевірки?
Детектори AI-контенту та детектори AI-патернів — різні інструменти. Детектори контенту шукають «чи написав AI» і часто помиляються. Детектори патернів шукають конкретні маркери роботизованості: рівномірний ритм, симетричні переліки, filler-фрази. Другі корисніші для редактури, бо дають конкретні точки виправлення.
Підсумок
Природність AI-тексту — це не магія і не талант. Це системний процес із трьох стадій: калібрування тону за еталонами, реструктуризація ритму через варіативність довжини речень та контекстне анкорування через первинні дані й авторську позицію. Для відеосценаріїв додається обов’язкова перевірка через TTS-озвучку. Впроваджений як повторюваний воркфлоу з еталонною бібліотекою, чеклістом та метрикою природності, цей процес скорочує час редактури вдвічі та підвищує утримання і цитованість контенту. Головна помилка — намагатися виправити все одним промптом. Головна перемога — перетворити редактуру на операційну систему, а не на індивідуальну майстерність.